Construyo UXMachine con agentes de IA que se reparten la programación, la revisión técnica, la documentación y los textos. Para coordinar ese trabajo uso un sistema de cinco capas: yo, que decido, y alrededor roles, herramientas, memoria y controles. Yo apruebo los cambios de alcance, el gasto, los permisos y lo que se publica.
He llegado a esta organización después de seis meses y tres versiones del producto. De la primera tiré el 75 %, la segunda la apagué y la tercera empezó de cero.
Los agentes hacen casi todo el trabajo de ejecución. Yo sigo dedicándole muchas horas.
Lo digo porque, cuando se habla de construir con IA, es fácil quedarse con la velocidad de producción. Pides algo y aparece. Una funcionalidad que antes habría requerido varios días puede estar funcionando esa misma tarde. Pero entre tener algo que funciona y saber si debías construirlo, si hace lo que pediste y si puedes publicarlo hay bastante trabajo.
Una parte importante de estos seis meses ha consistido en aprender a organizarlo. Qué puede decidir cada agente. Qué información necesita. Quién revisa su entrega. Qué pasa cuando dos asistentes discrepan. Dónde queda registrada una decisión para que no tengamos que volver a discutirla tres días después.
Este post explica cómo trabajo hoy. No es una receta ni una arquitectura definitiva. Es el sistema que he ido montando mientras construía un producto, después de encontrar problemas que no resolvía cambiando de modelo ni escribiendo un prompt más largo.
El problema de programar con IA: las decisiones que no has tomado
En abril tenía una IA que programaba, un chat para pensar y yo en medio.
El circuito parecía sencillo: explicaba lo que quería, recibía una propuesta, pedía cambios y terminaba aceptando una entrega. El problema era todo lo que quedaba implícito entre una instrucción y la siguiente.
Si no había definido cómo debía comportarse algo, el agente lo resolvía. Si faltaba una decisión sobre el alcance, asumía una. Si una frase le parecía mejorable, la cambiaba. Cada intervención tenía su lógica. El conjunto podía alejarse bastante de lo que yo quería construir.
Además, las decisiones quedaban repartidas entre conversaciones. Lo aprobado el lunes no siempre estaba disponible el viernes. Para mí seguía siendo una decisión tomada; para el agente que recibía el siguiente encargo podía no existir.
Y la revisión la hacía yo: la misma persona que había pedido el trabajo, que estaba aprendiendo mientras lo construía y que tenía todas las ganas de verlo funcionar.
Mi criterio estaba en mi cabeza. Las decisiones del agente, en cambio, acababan incorporadas al código y a los textos. Me costó el primer prototipo entero entender cuánto pesaba esa diferencia.
No le había pedido a la IA que decidiera por mí. Pero tampoco había definido con suficiente claridad qué tenía que consultarme. Había dejado un espacio vacío y el agente lo había ocupado para poder continuar.
Mi sistema de trabajo con agentes de IA en cinco capas
Hoy separo el sistema en cinco capas. Cada una responde a un problema distinto.
| Capa | Qué organiza | Qué problema intenta evitar |
|---|---|---|
| Yo | Qué apruebo yo y qué pueden resolver los agentes. | Que una suposición termine convertida en una decisión de producto. |
| Roles | Quién propone, ejecuta y revisa. | Que la misma IA dé por bueno su propio trabajo. |
| Herramientas | Dónde trabaja cada rol y con qué contexto. | Que se mezclen instrucciones, responsabilidades y conversaciones. |
| Memoria | Dónde quedan las decisiones y el estado del proyecto. | Que cada sesión reconstruya una versión distinta de lo acordado. |
| Controles | Qué se comprueba antes y después de publicar. | Que una entrega se acepte solo porque parece correcta o porque el agente lo afirma. |
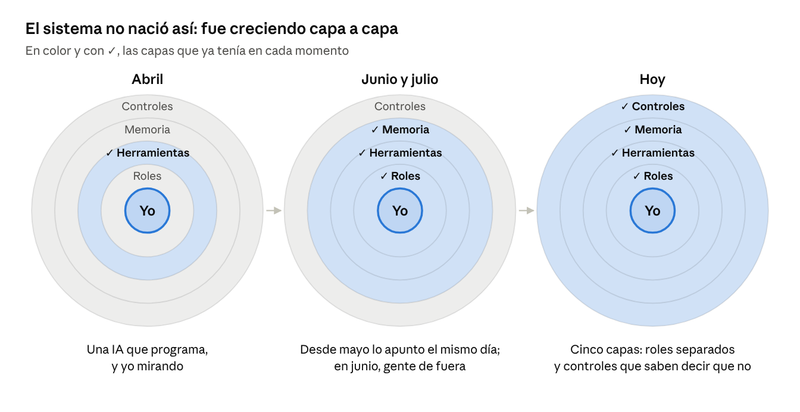
No llegaron a la vez. La memoria empezó a tomar forma en mayo, cuando vi que estaba perdiendo lo aprendido. En junio busqué otras miradas porque hasta entonces casi todo pasaba por mi propia evaluación. Los controles se reforzaron en septiembre, después del error más caro del proyecto.
Separar las capas me ayuda a localizar los problemas. Si un agente trabaja con una decisión antigua, tengo que revisar la memoria y el contexto que ha recibido. Si cambia un texto que debía copiar literalmente, ha cruzado un límite de su rol. Si una prueba deja pasar algo que debía bloquear, toca examinar el control.
Pedirle al agente que «tenga más cuidado» no me sirve de mucho. Necesito saber qué ha fallado y dónde intervenir.
1. Yo: qué delego en los agentes y qué apruebo
Los agentes proponen, construyen y revisan. Yo decido y firmo.
Firmar todo sería tan poco útil como no firmar nada. Si tengo que aprobar cada detalle de ejecución, el sistema se atasca en mí. Si doy una autorización demasiado amplia, puedo descubrir decisiones importantes cuando ya están implementadas.
La frontera que uso tiene que ver con las consecuencias del cambio.
Lo pequeño y reversible se puede resolver y comunicar. Lo que modifica el alcance, el gasto, quién tiene acceso o lo que se afirma en público requiere mi aprobación.
Esto último incluye los textos. En un producto que devuelve observaciones con evidencia y límites, cambiar una palabra puede cambiar lo que estamos afirmando. «Ya no se observa» y «está resuelto» no significan lo mismo. La segunda expresión exige una certeza que la primera no da.
Por eso la redacción forma parte de la definición del producto. Quien programa no tiene permiso para retocarla porque le parezca más clara o más comercial. Si detecta un problema, puede señalarlo. Resolverlo corresponde a otro rol y, cuando afecta a lo que publicamos, requiere mi aprobación.
Mi firma tampoco certifica que haya leído cada línea de código. Autoriza una decisión o una publicación a partir del encargo, la entrega y las comprobaciones disponibles. Si esa información es insuficiente, aprobar sería confiar en la explicación del agente sin tener cómo contrastarla.
Hay, además, una responsabilidad que sigo asumiendo directamente: el contacto con personas de fuera. Puedo pedir a varios asistentes que revisen un informe. Para saber si alguien lo entiende y le sirve, necesito observar qué ocurre cuando lo recibe.
2. Roles: quién propone, quién programa y quién revisa
Durante un tiempo pedía a la misma IA que pensara una solución, la implementara y comprobara si estaba bien.
Era cómodo: una conversación coherente en la que cada paso parecía justificar el anterior. Pero me costaba distinguir entre una comprobación y una explicación convincente del trabajo que acababa de hacer.
Ahora reparto esas tareas entre roles con instrucciones y límites escritos.
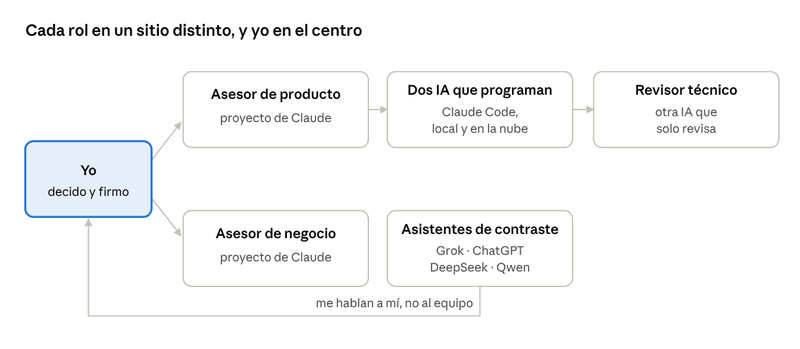
Asesor de producto: propuestas, encargos y textos
Propone qué hacer, prepara los encargos y redacta los textos que se van a publicar.
Su trabajo consiste en convertir una necesidad en algo suficientemente preciso como para ejecutarlo y revisarlo. Cuanto más ambiguo sale el encargo, más decisiones se trasladan a quien programa.
Preparar una propuesta no le da autorización para ejecutarla. Puede desarrollar una alternativa y argumentarla, pero eso no significa que yo la haya aprobado. Esta distinción parece obvia hasta que un documento muy bien escrito empieza a circular como si ya fuera una orden.
Asesor de negocio: mercado y lanzamiento
Trabaja sobre mercado, lanzamiento y cómo llegar a quien puede necesitar el producto.
Separarlo del asesor de producto me permite distinguir conversaciones que se influyen, pero que tienen objetivos diferentes. Una oportunidad comercial puede justificar que estudiemos un cambio. No basta, por sí sola, para dar ese cambio por aprobado.
También me ayuda a no resolver cada dificultad de negocio añadiendo funcionalidades. Construir es cada vez más fácil. Saber si hace falta construir algo más sigue siendo una decisión incómoda.
Agentes de programación: ejecución en local y en la nube
Trabajo con dos IA que programan: una en mi ordenador y otra en la nube. Ejecutan los encargos y aportan información sobre lo que encuentran en el código.
Aquí intento ser especialmente estricto con la frontera editorial. No eligen palabras ni deciden si una frase promete demasiado. Reciben textos cerrados y los incorporan literalmente.
Cuando necesito su análisis, les pido hechos: qué hace una parte del código, dónde se aplica una regla, qué cambió entre versiones o qué resultado dio una prueba. Esa información sirve para decidir. No les atribuye la decisión sobre lo que debería ofrecer o afirmar el producto.
Revisor técnico: revisión del código sin ejecutar el cambio
Otra IA revisa el cambio sin haberlo programado. Examina la entrega antes de aceptarla y adjudica los desacuerdos técnicos dentro de su ámbito.
Así la revisión no depende únicamente de quien ha construido. Hay otra lectura y los desacuerdos tienen que hacerse explícitos.
Sigue siendo una IA y puede equivocarse, pero al menos la aceptación no descansa en la misma conversación que produjo el código.
Si la discusión deja de ser técnica y afecta al alcance o al comportamiento que quiero ofrecer, vuelve a mí.
Asistentes de contraste: otra lectura fuera del contexto del equipo
Son otros asistentes a los que paso material sin todo el contexto acumulado del equipo. Me responden a mí, no a los demás roles.
Busco que puedan cuestionar una propuesta sin haber participado en las conversaciones que nos llevaron hasta ella. Esa distancia tiene ventajas y límites: pueden detectar algo que hemos normalizado, pero también objetar algo que ya estudiamos y descartamos por una razón válida.
Los uso para contrastar. Que varias IA estén de acuerdo no equivale a que un usuario haya entendido el producto ni a que alguien vaya a pagar por él.
Las instrucciones de cada agente: responsabilidades y límites
Cada rol tiene instrucciones fijas. Las del asesor de producto se organizan en cinco apartados:
| Apartado | Qué dejo escrito |
|---|---|
| Contexto | En qué punto está el producto y bajo qué restricciones trabaja. |
| Qué decide | Qué puede resolver dentro de su ámbito y del alcance aprobado. |
| Qué no decide | Qué queda fuera de su responsabilidad, como el precio o la autorización para publicar. |
| Si falta una prueba | Debe identificar el supuesto y distinguirlo de lo comprobado. |
| Quién decide al final | Qué cuestiones deben volver a mí. |
El apartado al que más atención presto es «qué no decide».
Un agente suele encontrar maneras de continuar. A veces esa iniciativa ayuda; otras veces atraviesa una frontera que yo daba por entendida. Escribir el límite me permite señalar una desviación concreta, en lugar de discutir después qué significaba «ayudar».
3. Herramientas: cómo organizo los agentes en Claude y Claude Code
Cada rol necesita un espacio de trabajo con sus instrucciones y sus documentos.
Los asesores viven en proyectos de Claude. Las IA que programan trabajan en Claude Code. Los asistentes de contraste reciben por separado el material que quiero que revisen.
Esta distribución determina qué contexto tiene cada uno. Una decisión puede estar perfectamente documentada y no llegar al agente que la necesita. Tenerla guardada no basta: debe estar accesible cuando se prepara o se ejecuta el encargo.
Por eso un espacio propio para cada rol ayuda, pero no resuelve por sí solo la coordinación. También importa qué información pasa de uno a otro.
El encargo debe trasladar las decisiones relevantes. No puedo esperar que quien programa reconstruya una conversación a la que no tiene acceso, ni que distinga entre una propuesta antigua y una decisión vigente si le entrego ambas sin aclararlo.
Las herramientas han cambiado desde abril y seguirán cambiando. Les dedicaré otro post porque sus diferencias prácticas importan. Pero cambiar de herramienta no arregla una responsabilidad mal definida ni recupera una decisión que nadie registró.
4. Memoria: cómo documento las decisiones y el estado del proyecto
Mi necesidad de memoria es bastante concreta: que el siguiente encargo parta de lo que hemos decidido y de lo que existe hoy.
No puedo confiar en que un agente recupere una decisión de otra conversación. Tampoco en acordarme yo de todo, aunque en el momento me parezca imposible olvidarlo.
Para eso mantengo tres piezas que cumplen funciones diferentes.
Registro de decisiones: qué se aprobó y por qué
Guarda qué se decidió, cuándo y por qué.
El motivo importa. Sin él, una decisión antigua puede parecer una prohibición arbitraria o una idea que nadie llegó a considerar bien. Con el motivo puedo distinguir entre una propuesta que repite una discusión cerrada y otra que merece reabrirla porque las condiciones han cambiado.
Registrar una decisión no impide revisarla. Me permite hacerlo sabiendo qué estoy cambiando.
Estado del proyecto: dónde estamos y qué sigue
Un único documento recoge dónde estoy, qué queda pendiente y por dónde empezar después. Es lo primero que le paso al asesor al arrancar.
No cumple la misma función que el registro de decisiones. Uno conserva el razonamiento; el otro permite retomar el trabajo sin leer toda la historia del proyecto.
De todo el sistema, este hábito es probablemente el que mejor relación tiene entre esfuerzo y utilidad: dejar unas líneas al cerrar el día. Me sirven a mí y al agente que entra en la siguiente sesión.
Historial en GitHub: cambios y versiones del código
GitHub guarda las versiones y permite consultar qué cambió y recuperar estados anteriores del código.
Es una memoria distinta. El historial puede mostrar cómo quedó implementado algo, pero no siempre explica por qué lo quisimos así. Tampoco recuperar una versión del código deshace necesariamente todas las consecuencias de haberla publicado.
Necesito las tres piezas porque responden a preguntas diferentes: por qué decidimos algo, dónde estamos ahora y qué se modificó realmente.
5. Controles: pruebas de software y comprobaciones antes y después de publicar
Esta fue la capa que más tarde reforcé y la que más me ha enseñado.
Hoy la organizo alrededor de tres reglas:
- No se publica si no pasan todas las pruebas exigidas.
- Cada control debe demostrar que detecta un fallo deliberado que debería bloquear.
- Después de publicar se comprueba lo que ha quedado en la web.
La primera parece evidente. La dificultad está en que las pruebas cubran aquello que importa y en que su resultado tenga consecuencias. Si fallan, la publicación debe detenerse.
La segunda regla intenta comprobar precisamente eso.
Pruebas negativas: comprobar que un fallo bloquea la publicación
Un control puede aparecer en el proceso, ejecutarse y terminar en verde sin estar comprobando lo que creemos. Para saber si responde ante un fallo concreto, introduzco ese fallo a propósito y compruebo qué ocurre.
Es una prueba negativa: además de verificar que el caso correcto pasa, compruebo que un caso incorrecto se rechaza.
No demuestra que el control detecte cualquier problema. Demuestra que detecta ese fallo y que el rechazo llega a impedir la publicación.
El 16 de octubre fallaron las pruebas y el sistema no publicó nada. Ese día el bloqueo hizo su trabajo.
Comprobación en producción: qué puede verificar UXMachine
La tercera regla mira la web publicada. Una comprobación previa y una observación sobre la versión que recibe el usuario ocurren en momentos diferentes. Necesito ambas.
UXMachine participa en esa revisión posterior midiendo la web con sus reglas. Comprueba lo que está dentro de su alcance, con su evidencia y sus límites. Lo que sus reglas no cubren sigue necesitando otra verificación.
De la idea a producción: el recorrido de un cambio en UXMachine
Las cinco capas se entienden mejor siguiendo una modificación desde que la decido hasta que está publicada.
| Paso | Qué ocurre | Qué permite comprobar |
|---|---|---|
| 1. Decisión | Defino qué quiero cambiar. | Que existe una decisión de trabajar en ese cambio. |
| 2. Encargo | El asesor concreta la ejecución y los textos. | Qué se ha pedido exactamente. |
| 3. Construcción | Una IA implementa el cambio en una copia de trabajo. | Qué ha construido a partir del encargo. |
| 4. Pruebas | Se ejecutan las comprobaciones exigidas. | Si cumple las condiciones que esas pruebas cubren. |
| 5. Revisión técnica | Otra IA examina el cambio. | Si encuentra problemas o discrepancias que deban resolverse. |
| 6. Firma | Apruebo la publicación. | Que autorizo esa entrega con la información disponible. |
| 7. Registro y publicación | El cambio queda guardado y se publica. | Qué versión ha salido. |
| 8. Comprobación posterior | Se revisa la web publicada y se vuelve a medir. | Qué se observa después de publicar, dentro del alcance de cada comprobación. |
El encargo tiene bastante peso en todo esto. Es la referencia que permite comparar lo solicitado con lo entregado. Si está mal definido, las siguientes etapas pueden comprobar con mucho rigor algo que yo no quería.
También importa no confundir los resultados de cada paso. Pasar las pruebas no equivale a tener autorización para publicar. Una revisión técnica favorable no valida una promesa comercial. Mi firma no amplía lo que las pruebas han comprobado.
Ocho pasos parecen muchos para un cambio pequeño. Casi todos los ejecutan los agentes. Mi trabajo se concentra en decidir, resolver las cuestiones que salen de su ámbito y aprobar la entrega.
Sigue habiendo fricción. Tengo que leer, corregir encargos y discutir resultados. La diferencia es que ahora puedo localizar mejor dónde se ha producido un desacuerdo y qué información falta para resolverlo.
Qué no resuelve este sistema: utilidad, usuarios y mercado
Puedo tener los roles bien separados, las decisiones registradas y todas las pruebas en verde, y estar construyendo algo que nadie necesita.
El sistema organiza la producción y su revisión. No demuestra que haya mercado, que alguien vaya a pagar o que el informe resulte útil a quien lo recibe.
Esta distinción me parece especialmente importante trabajando solo. Mejorar el proceso produce una sensación de avance muy convincente. Siempre hay una instrucción que afinar, una comprobación que añadir o una herramienta nueva que probar. Puedo pasarme el día haciendo eso.
Además, los agentes siempre tienen alguna propuesta para seguir trabajando. El hecho de que puedan ejecutar otra tarea no significa que esa sea la tarea que más necesita el proyecto.
Por eso el contacto con la realidad externa sigue siendo mi responsabilidad. Necesito personas que usen el producto, que no entiendan algo, que vuelvan o que no vuelvan. Y necesito dedicar tiempo a averiguar por qué.
Lo que viene: los errores que cambiaron mi forma de trabajar
Este sistema no salió de un diseño previo. Salió de tropiezos. En el siguiente post cuento los de estos seis meses y qué cambié después de cada uno. Especialmente el de septiembre, el error más caro del proyecto, que me obligó a revisar cómo estaba comprobando las entregas.
Después vendrán las reglas, las herramientas y una decisión que merece una explicación aparte: por qué UXMachine, construido con tanta ayuda de la IA, acabó sin usar modelos de IA para diagnosticar webs.
Esta temporada también lo comparto, en versión resumida, en el máster en dirección de marketing digital que codirijo. Me interesa llevar a clase el proceso completo, incluido el trabajo descartado y las decisiones que todavía no sé si han sido acertadas.
Y si tú también construyes con agentes, prueba UXMachine con tu web. Mide la página en un navegador real después de cada cambio y te devuelve qué ha observado, dónde y qué no ha podido comprobar. Es la misma comprobación que uso yo en la última capa de este sistema.