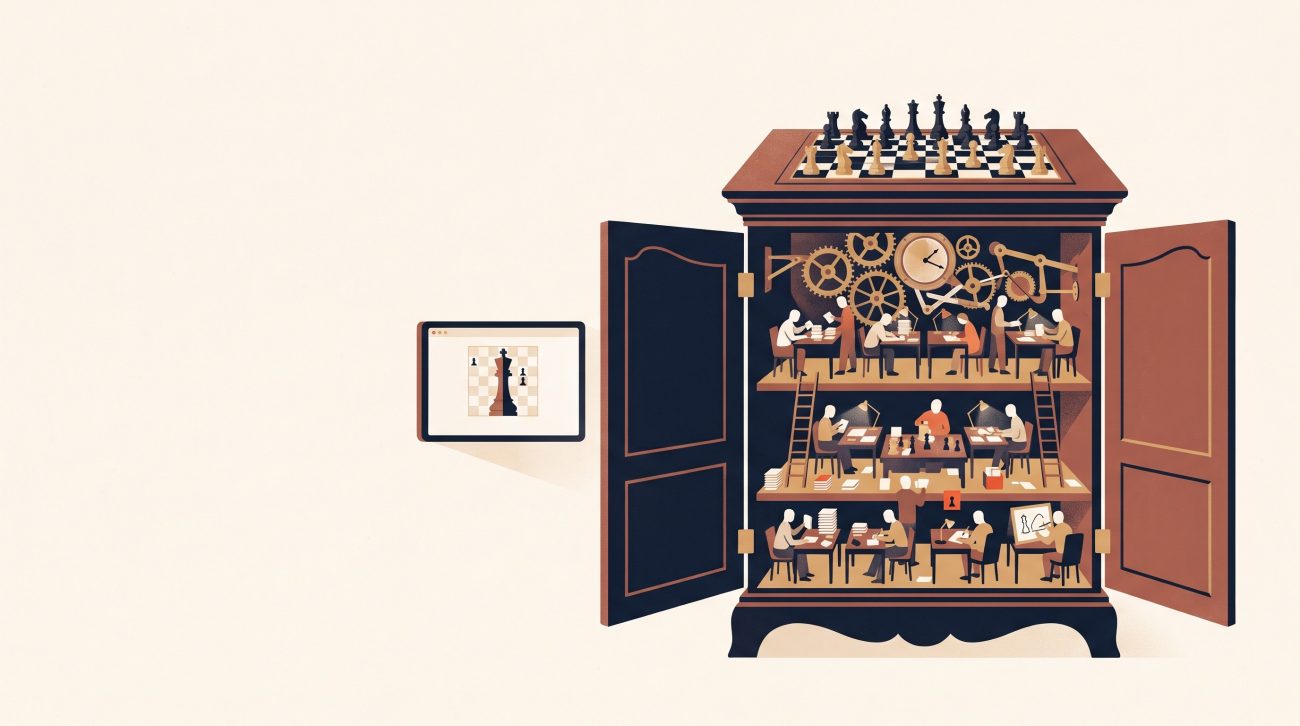
En 1770, Wolfgang von Kempelen presentó en la corte de Viena una máquina que jugaba al ajedrez. Era un autómata vestido a la turca, sentado tras un armario lleno de engranajes, que ganó partidas en media Europa durante décadas. El truco estaba dentro del armario: un jugador humano escondido movía las piezas.
En 2005, Amazon puso en marcha un servicio para encargar pequeñas tareas a personas a través de internet y lo llamó Mechanical Turk. El nombre era un guiño a aquel autómata. Y la idea, bastante parecida: tareas que parecen hechas por una máquina y que en realidad hace alguien a quien no se ve.
Cuando escribes una instrucción y recibes una respuesta en segundos, la experiencia tiene algo de magia. Parte de esa magia consiste en que no ves a nadie. Ni a quien etiquetó los datos con los que se entrenó el sistema, ni a quien evaluó sus respuestas, ni a quien revisó lo que no debía decir.
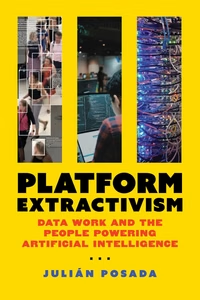
Platform Extractivism: Data Work and the People Powering Artificial Intelligence, de Julián Posada (University of California Press, 2026), obliga a abrir el armario. Posada es científico de la información y profesor en la Universidad de Yale. Su investigación, con métodos mixtos, se centra en tres plataformas del sector del trabajo de datos en Venezuela, un país donde la crisis económica ha condicionado por completo la relación entre los trabajadores y las empresas que contratan esos servicios.
Un trabajo con historia
Este trabajo no es nuevo ni marginal. ImageNet, la gran base de imágenes etiquetadas que a partir de 2009 sirvió para entrenar y comparar sistemas de visión artificial, se construyó en buena parte con trabajadores de Mechanical Turk que clasificaban fotografías una a una. En 2019, Mary L. Gray y Siddharth Suri le pusieron nombre en Ghost Work: el trabajo fantasma que sostiene servicios que se presentan como automáticos.
Con los modelos de lenguaje, el volumen y la variedad han crecido. En enero de 2023, una investigación de la revista Time reveló que trabajadores contratados en Kenia a través de la empresa Sama para filtrar contenido violento y abusivo con destino a OpenAI cobraban menos de dos dólares la hora. El caso tuvo mucho eco porque ponía un precio y unas condiciones concretas a algo que solía describirse en abstracto.
Posada mira otro lugar y otra forma de llegar a este trabajo. Lo que comparten los casos es la distancia: entre quien hace la tarea y quien la paga, y entre ambos y quien usa el resultado.
La IA no es tan artificial como parece
El libro cuestiona una parte del relato habitual: el que presenta la IA como una tecnología que funciona casi al margen de las personas. La editorial lo formula sin rodeos. Para Posada, lo que hoy llamamos IA no es artificial, ni autónomo, ni inteligente. Depende de las personas y extrae valor de ellas.
Se puede discutir la contundencia de la frase. El fondo es más difícil de discutir. No hace falta negar los avances de los modelos para recordar que se apoyan en cadenas de trabajo, infraestructuras materiales y relaciones económicas que rara vez aparecen en una demostración comercial.
Un extractivismo con raíces antiguas
Posada describe estas plataformas como motores de extracción arraigados en desigualdades sociales y en diferencias de poder entre países que vienen de lejos. Según la editorial, muestra cómo las plataformas han aprovechado la inestabilidad económica para captar a poblaciones vulnerables. El índice da una idea del recorrido: la dependencia como modelo de negocio, quién decide el significado de los datos, cómo se reparten los riesgos de trabajar por encargo. Uno de los capítulos lleva un título que lo resume bien, «No Data Without Territory»: no hay datos sin territorio.
Esa idea del significado me parece la más fértil. Quien etiqueta decide qué es un insulto, qué es una imagen violenta o qué respuesta suena mejor. Son decisiones de criterio, tomadas a destajo y desde contextos culturales que no siempre coinciden con los de quien usará el sistema. Lo que el modelo aprende como neutral lleva dentro miles de esas decisiones.
Ya había tocado algo parecido al escribir sobre The Age of Extraction. Allí el problema era el peaje que cobra una plataforma por estar en medio. Aquí es otro: cómo se reparten los beneficios y los costes de producir aquello que la plataforma vende.
La contradicción de la sustitución
Hay algo especialmente contradictorio en todo esto. Hablamos sin parar de la IA como sustituta del trabajo humano mientras seguimos necesitando personas para preparar datos, evaluar respuestas, moderar contenidos y corregir errores.
Y obliga a ampliar el foco. La relación entre IA y desigualdad no se agota en cuántos empleos desaparecerán en los países ricos. Tiene que ver también con quién hace las tareas menos visibles, desde dónde las hace y quién se queda con el valor que generan.
Lo que se le puede objetar
La objeción más habitual a este tipo de investigaciones es económica. Para muchas personas en Venezuela, o en Kenia, este trabajo puede ser una fuente de ingresos en dólares mejor que las alternativas locales. Criticarlo desde fuera, se dice, es fácil cuando no se depende de él.
Es una objeción seria y no la despacharía con una frase. Pero que un trabajo sea preferible a la alternativa no dice nada sobre si sus condiciones son justas, ni sobre quién fija esas condiciones. Precisamente lo que Posada estudia es cómo la falta de alternativas se convierte en parte del modelo de negocio.
Hay una segunda objeción, más técnica. Una parte creciente del etiquetado y la evaluación ya la hacen otros modelos. Quizá dentro de unos años este trabajo haya menguado mucho. Puede ser. Pero mientras exista, la pregunta por sus condiciones sigue en pie, y la historia de ImageNet sugiere que cada salto técnico ha necesitado su propia oleada de trabajo humano antes de prescindir de ella.
Lo que dejan tres entregas
Esta es la tercera entrega de una pequeña serie sobre quién se queda con el poder de la IA, y vale la pena parar a ver qué ha cambiado por el camino.
Empecé con Cecilia Rikap pensando sobre todo en mi dependencia como usuario: de qué nubes y de qué proveedores dependo para construir. Con Buchanan y Collins la pregunta subió de escala, hasta los Estados y la geopolítica. Posada la lleva en la dirección contraria, hacia abajo, hasta las personas que hacen posible que el modelo funcione y que no aparecían en ninguna de las dos conversaciones anteriores.
La primera conclusión es que no deberíamos confundir el acceso a la IA con el reparto del poder que produce. Los modelos pueden ser cada vez más accesibles mientras la infraestructura, los beneficios y las decisiones siguen concentrados. Lo que añade esta tercera lectura es que esa concentración ocurre a la vez en la parte alta y en la parte baja de la cadena. Arriba deciden unas pocas empresas y unos pocos Estados. Abajo, mucha gente dispersa hace un trabajo imprescindible sin capacidad de negociar casi nada, y los usuarios, entre unos y otros, vemos una interfaz limpia y una factura razonable.
La segunda abre la siguiente serie, que empieza el lunes. Si la IA está transformando tanto el trabajo, quizá deberíamos preocuparnos menos por contar tareas automatizadas y más por entender qué clase de trabajo estamos creando.
Al turco de Von Kempelen se le acabó el misterio cuando se supo qué había dentro del armario.
Con la IA, saberlo no debería depender de que alguien lo descubra.