Un agente resuelve por la mañana un problema que a una persona le habría llevado un día entero. Por la tarde se equivoca en algo que un becario no fallaría. Lo inquietante no es el error. Es que no había manera de verlo venir.
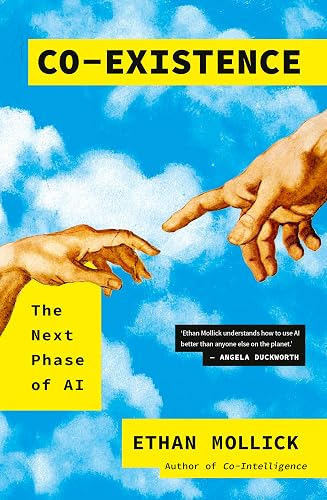
Esa experiencia, que reconoce cualquiera que trabaje a diario con estos sistemas, es el punto de partida de Co-Existence: The Next Phase of AI, de Ethan Mollick (Portfolio, 2026). Mollick, profesor en Wharton y autor de la newsletter One Useful Thing, plantea el libro como la continuación de Co-Intelligence (Portfolio, 2024; en castellano, Cointeligencia). Aquel estaba pensado para la etapa del chatbot: una caja de texto, una conversación de ida y vuelta y una persona claramente al mando. Este parte de otra situación. Los sistemas ya investigan, programan y encadenan tareas con bastante autonomía, y la pregunta deja de ser cómo hablar con ellos para convertirse en cómo convivir con máquinas que a veces —no siempre— hacen nuestro trabajo mejor que nosotros.
La clave está en ese «no siempre». Y en lo que nos cuesta aceptarlo.
Acertar lo difícil no garantiza acertar lo fácil
El concepto que vertebra el libro tiene un origen empírico concreto. En 2023, un equipo de investigadores de Harvard, Wharton, MIT y Warwick —con Mollick entre los autores— hizo un experimento con 758 consultores de Boston Consulting Group, cerca del 7% de su plantilla de consultores. Les asignaron tareas realistas de consultoría, unos con acceso a GPT-4 y otros sin él. El trabajo circuló primero como documento de trabajo de Harvard Business School y se publicó en 2026 en Organization Science con el título «Navigating the Jagged Technological Frontier».
En las tareas que caían dentro de las capacidades del modelo, los resultados fueron muy claros: los consultores con IA completaron un 12,2% más de tareas, lo hicieron un 25,1% más rápido y con una calidad más de un 40% superior. Pero los investigadores habían diseñado además una tarea pensada para quedar fuera de esas capacidades. En ella, quienes usaban la IA tuvieron 19 puntos porcentuales menos de probabilidad de llegar a la respuesta correcta que quienes trabajaron sin ella.
Lo paradójico es que esa tarea no parecía más difícil que las otras. Para un consultor experto era un análisis de negocio más. De ahí el nombre: una frontera irregular, jagged, en la que tareas que a una persona le parecen de dificultad parecida caen a uno u otro lado de la línea sin aviso previo.
La frontera irregular no se ve desde dentro
Si la frontera fuera una línea recta —fácil a un lado, difícil al otro— convivir con ella sería sencillo. Bastaría con aprender dónde está. El problema es que tiene entrantes y salientes que no siguen la intuición humana sobre lo que es complicado. Un sistema puede razonar con soltura sobre un problema de estrategia y equivocarse en una cuenta que cabe en una servilleta.
Hay un segundo agravante, menos comentado y probablemente más serio: la respuesta equivocada llega con el mismo acabado que la correcta. La misma prosa limpia, la misma estructura, la misma seguridad. Fuera de la frontera, el sistema no titubea. Y nosotros, que llevamos toda la vida usando la forma de una respuesta como pista de su calidad, nos quedamos sin esa pista.
Mollick añade una tercera complicación: la frontera se mueve con cada modelo. Lo que hoy cae fuera puede quedar dentro en seis meses, y nada garantiza que no aparezcan zonas nuevas de fallo donde antes no las había. Cualquier mapa que hagamos es provisional. Conviene tratarlo como tal.
Competencia no es fiabilidad
Todo esto obliga a separar dos ideas que en el trato con personas solemos fundir. La competencia es lo que alguien es capaz de hacer en su mejor momento. La fiabilidad es con qué frecuencia lo hace, en qué condiciones y con qué margen de sorpresa. Una demostración enseña competencia. Solo la repetición enseña fiabilidad.
Con los humanos, inferir una cosa de la otra funciona bastante bien porque la pericia humana tiende a estar ordenada. Quien resuelve integrales sabe sumar. Quien redacta un buen contrato no suele olvidarse de poner la fecha. Construimos la confianza profesional sobre esa escalera implícita: si alguien sube los peldaños altos, damos por hecho que pisa los bajos. Con la IA, esa inferencia se rompe.
Y confundirlas no sale gratis. Un sistema que nos impresiona en lo difícil nos invita a delegarle lo fácil sin mirar, justo donde puede fallar. Un sistema que nos decepciona en algo trivial nos empuja a descartarlo en terrenos donde haría un trabajo mejor que el nuestro. En los dos casos el error es el mismo: juzgar la fiabilidad por la última impresión de competencia. El resultado no es prudencia. Es delegación a ciegas, en un sentido o en el otro.
El criterio se forma corrigiendo, no recibiendo respuestas
Donde esta distinción se vuelve más incómoda es en el aprendizaje. Uno de los autores principales del estudio de BCG, Fabrizio Dell’Acqua, hizo un experimento aparte con reclutadores que evaluaban candidatos con ayuda de sistemas de IA de distinta calidad. Quienes trabajaban con la herramienta buena tendían a desconectarse: aceptaban sus recomendaciones y dejaban de ejercer su propio juicio. Quienes trabajaban con una herramienta deliberadamente peor se mantenían atentos, la cuestionaban y mejoraban con la práctica. Dell’Acqua lo resume con una imagen precisa: quedarse dormido al volante.
La conclusión pesa para cualquiera que se dedique a formar profesionales. El criterio no se forma recibiendo respuestas correctas, sino detectando las incorrectas. Es un músculo que crece con la fricción de encontrar el fallo, contrastarlo y corregirlo. Una herramienta que acierta casi siempre elimina buena parte de esa fricción. Y lo hace justo en la etapa en la que alguien está aprendiendo un oficio y todavía no tiene el criterio que necesitaría para pillar el «casi».
En la formación de profesionales —el terreno en el que llevo años trabajando, en Foxize y en la UPF-BSM— esto desplaza la pregunta. Ya no basta con enseñar a usar la herramienta, ni siquiera a usarla bien. Hay que enseñar a sospechar de ella con método: dónde suele fallar en este dominio, cómo se comprueba, qué señales indican que la respuesta ha salido de la frontera aunque suene igual de bien. Lo que está en juego no es la productividad de un trimestre. Es si dentro de unos años habrá gente capaz de supervisar a las máquinas en las que hoy delegamos.
Delegar exige saber qué se está delegando
Mollick plantea la convivencia con estos sistemas como una negociación permanente: qué delegamos, qué supervisamos y qué conviene seguir haciendo nosotros. Dicho así suena razonable. Bajado a lo concreto, tiene una trampa.
Para repartir bien el trabajo hay que saber dónde está la frontera en las tareas propias. Y ese mapa no lo puede hacer nadie por nosotros. Un estudio con consultores dice algo sobre consultoría; no dice nada sobre si el sistema acierta o falla en la clase de análisis que hace un abogado laboralista, un ingeniero de datos o un profesor de secundaria. Cada oficio tiene que dibujar su propia línea, y redibujarla cada vez que cambia el modelo.
La trampa está en que dibujar esa línea exige justo la pericia que corremos el riesgo de perder delegando. Solo quien sabe hacer el trabajo detecta cuándo la máquina lo ha hecho mal sin que lo parezca. Es una forma de dependencia circular: cuanto mejor delegamos, menos practicamos lo que necesitamos para seguir delegando bien. No tiene solución elegante. Tiene, como mucho, disciplina.
La confianza se construye con mecanismos, no con impresiones
Nada de lo anterior lleva a la conclusión de que estos sistemas no son fiables y, por tanto, no conviene usarlos. Esa sería la lectura perezosa, y es tan equivocada como la entusiasta. Los datos del propio estudio de BCG dicen que dentro de la frontera la ganancia es enorme. Renunciar a ella por miedo a la zona de fallo sería otra forma de juzgar la fiabilidad por la última impresión.
La lectura útil es otra: la confianza tiene que apoyarse en mecanismos de verificación, no en la sensación de competencia que deja una respuesta bien escrita. Comprobaciones independientes, contraste con fuentes, pruebas que no dependan del mismo sistema que hizo el trabajo, segundas opiniones en lo que importa. Puede parecer obvio. No lo es tanto cuando la respuesta llega en segundos, suena impecable y hay prisa.
Hay una pregunta que nadie puede cerrar todavía: si la frontera irregular es una fase de esta generación de modelos o un rasgo estable de la tecnología. Quizá cada versión nueva la suavice hasta volverla irrelevante; quizá solo la desplace a terrenos donde todavía no hemos mirado. Una reseña del Financial Times describía el libro como una guía para estos años intermedios en los que la IA es buena, pero no tanto. Puede que sean intermedios. Puede que duren más de lo que pensamos.
Mientras tanto, la pregunta cambia de forma. Ya no es si la IA es fiable.
Es en qué, para qué y comprobado cómo.